前沿科技 / 2026年11月18日 / 全文共1819字
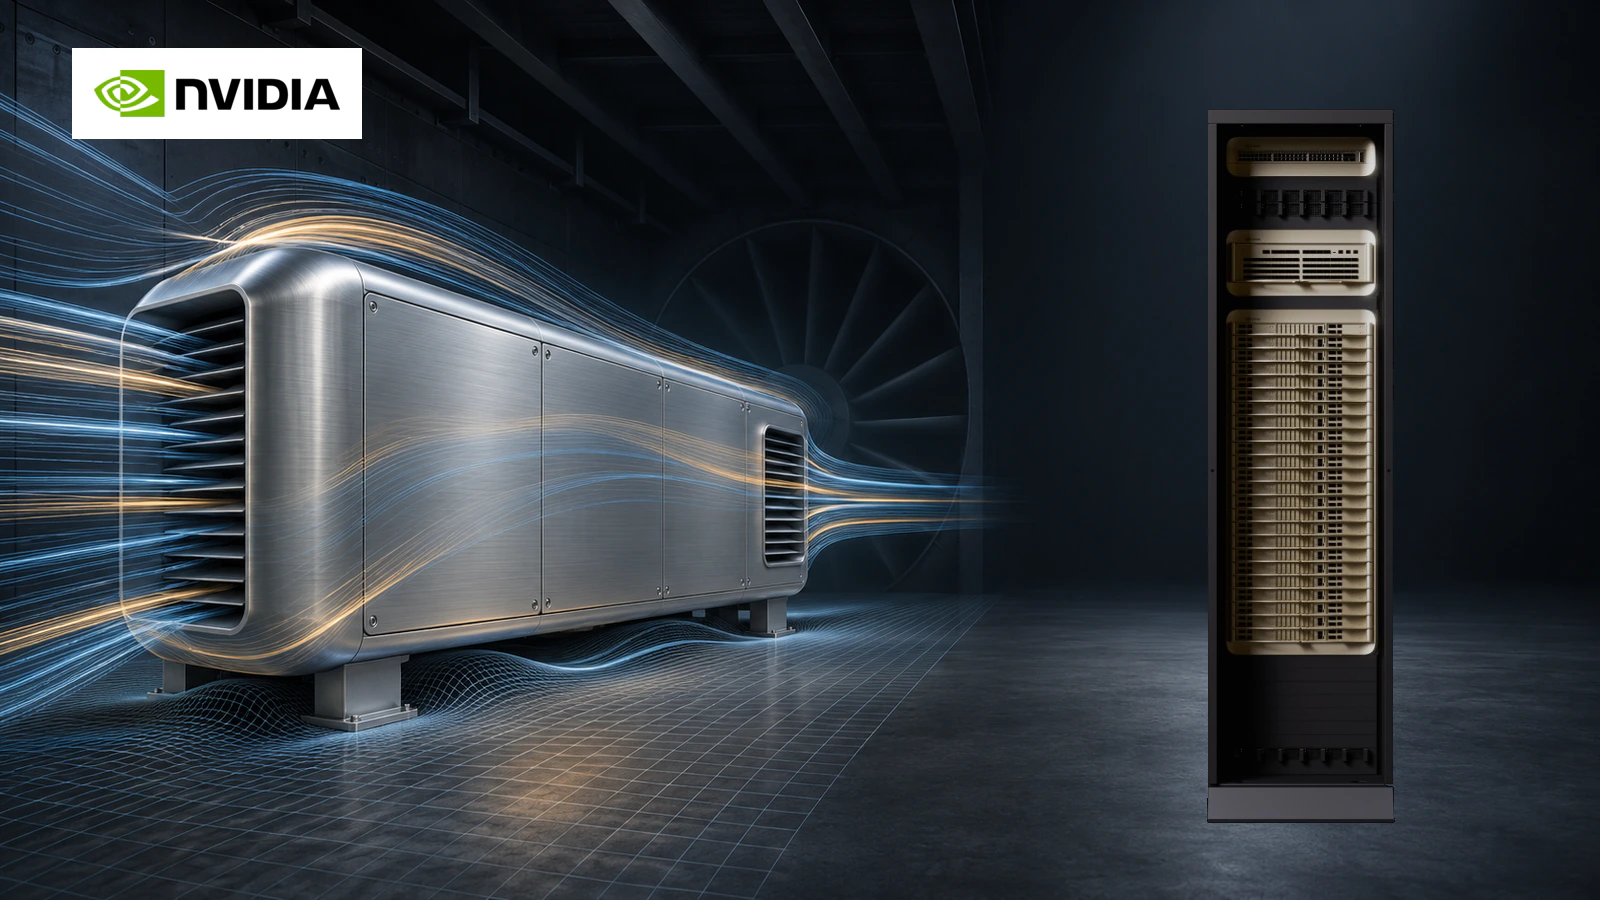
11月16日,英伟达在芝加哥的SC26大会上发布Vera CPU机柜,将192颗处理器通过InfiniBand网络连成科学计算平台,预计2027年初由合作厂商开始供应。它面向气流、天气和分子等仿真任务。一项设计即使由AI提出,计算流体运动、检验设计是否满足要求,仍要把求解程序放到合适的硬件上运行。
英伟达给出的一个例子是OpenFOAM里的motorBike Large算例,用大量网格模拟摩托车周围的气流。厂商报告的性能和每瓦性能分别为对照平台的1.9倍、2.4倍。这组结果来自双路CPU节点。采购时要弄清的还有机柜能否持续跑完客户的算例,以及为此需要多少电、软件适配和冷却投入。
气流仿真为什么会等数据
可以设想,一家设计团队用AI生成几种设备外壳,再通过气流仿真检查散热或风阻。每种方案都要划分网格、设置边界条件,然后反复求解压力和速度。只有达到约定收敛条件、误差可以接受的结果,才有资格参与下一轮设计比较。
这类求解需要反复读取网格和相邻区域的数据。一个核心算完自己的部分,还得等其他核心或节点交换边界信息。内存供数较慢、数据放置不合适,或节点间等待太久,都会拖长一次求解。增加处理器数量后,通信时间也可能随之上升。
布里斯托大学团队发布的独立论文,比较了Vera与英伟达Grace、AMD Turin及英特尔Granite Rapids。研究使用的是单插槽Vera工程样机,对照的AMD和英特尔处理器来自云端裸金属实例。作者将各项测试限定在单插槽范围,并记录了软件配置。
论文发现,Vera在多数受测代码中表现较好,较高的内存带宽是重要原因。OpenFOAM在该单节点条件下受内存带宽限制,能从更快的数据供给中获益。论文也记录了部分计算密集型程序上x86平台的优势,包括分子动力学程序GROMACS,并指出针对Arm的程序和数学库优化仍有工作要做。软件怎样使用硬件,会改变最后的运行时间。
这项研究支持按工作负载判断CPU能力。它由大学研究团队完成,英伟达提供了工程样机访问。论文可以帮助解释Vera适合哪类任务,购买整柜后的用电和跨节点效率,还需要另测。
每瓦性能提高,电表会怎样变化
英伟达技术简报把OpenFOAM对照平台列为双路AMD EPYC 9755,Vera平台也使用两颗CPU。两边的内存和系统配置有差异,简报列出了编译器与OpenFOAM版本。1.9倍性能和2.4倍每瓦性能,属于这组平台在指定算例上的测试结果。
每瓦性能表达单位功率能完成多少工作。若两个系统按相同质量要求完成同一份固定工作,测量口径也一致,那么每瓦性能达到2.4倍,理论上对应任务用电约为原来的42%。这是根据比值作的条件换算,机房总用电还包括网络、存储和冷却,不能直接用这个数字估算整柜电费。
例如,客户可以固定网格、湍流模型、迭代终止标准和输出频率,用同一项任务比较两套系统。记录插座端或机柜配电端的电量,同时保存开始、结束时间,再核对两边计算结果是否满足相同误差标准。如果改变了网格大小或收敛门槛,就需要重新说明比较条件。
投黑马更愿意看每次合格仿真的千瓦时。一个平台可能功率较高,但更早结束工作,最终耗电较少。也可能节点增加以后,大部分时间花在交换数据上,机器仍持续耗电。把结果质量、完工时间和实际用电放在同一条任务记录里,才能让研发团队与机房运维核对收益。
整柜配置和落地时间要分别核对
本次公告中的Vera CPU机柜为192颗CPU,采用液冷。技术简报另列出32个托盘、共256颗CPU的满配参考设计。两份材料没有把这些配置逐项对齐,客户询价时需要锁定实际交付的托盘、网络、供电与液冷配置。本文以本次公告的192颗为发布口径。
简报中的多节点测试最多用到12个Vera节点,对照是上一代Grace平台。英伟达明确写明,当时没有竞争厂商集群可供这项评估。节点内的气流测试和这组扩展测试,回答的是不同问题。后续要确认同一算例加到更多节点以后,等待通信的时间占了多少,额外用电能否换来足够的完工时间缩短。
德国气候计算中心已经选用Vera参与下一代HLRE-5系统,但这项采购在10月就已公布,预计2028年初投入使用。该系统同时包括CPU和GPU分区,采用Bull的平台、独立网络与冷却方案。中心预计每个模拟年的能耗较现有系统下降约75%,这是未来混合系统的整体目标,不能单独归到本次机柜。
软件交付同样影响可用时间。英伟达称HPC SDK 26.11已经可用,新一代Fortran编译器进入公开测试。迁移已有仿真程序时,团队仍需验证所用数学库、通信库、自定义模块和结果一致性。编译成功只是开始,跑完客户常用的算例才有可能进入生产排期。
创业团队可以先接哪一段工作
对仿真软件、计算服务和Arm迁移团队,客户手上已有的算例就是试点入口。可以先选择一项反复运行、耗时和质量标准都明确的任务,测出内存访问、通信、文件输出各占多少时间,再决定优化程序、调整数据位置,还是更换硬件。
投黑马会把软件迁移的人天、客户验算工时和后续维护一起计入每次合格仿真的成本。若一项代码改动能在现有设备上解决瓶颈,团队可以先交付这项改善。需要新硬件时,再用相同算例复测,核对采购、用电和冷却投入在实际利用率下如何摊销。
现有公开材料还没有给出这批机柜的成交价格或客户整柜持续运行记录。接下来最有用的证据,是同一份客户算例在明确配置上连续运行,交付相同质量的结果,并留下可复查的时间与电量。设计团队据此才能判断,在固定研发预算内究竟能多验证几种方案。
── 投黑马研究团队
